AI時代のGitHubへのうっかり情報流出をどう防ぐか
はじめに
トヨタは2022年10月7日の発表で、委託先がT-Connectのソースコードの一部を誤って公開設定でGitHubへアップロードし、データサーバーへのアクセスキーも含まれていたと報告した。 2017年12月から2022年9月15日まで公開状態にあり、メールアドレスとお客様管理番号296,019件が漏洩した可能性があるとしている。
マネーフォワードも、GitHubのリポジトリ内に個人情報を含むファイルを保管していた。 2026年5月1日の第一報では、流出した認証情報を使った第三者が不正アクセスし、リポジトリをコピーしたと報告し、6月23日の第四報では、流出した可能性のある個人情報はリポジトリ内のものに限定され、本番環境からの漏えいはないと説明した。
開発の保管場所には、コードと一緒に認証情報や実データまで入り込み得る。 AIに開発の操作を任せる際にも、まず入れてよい情報を決め、その約束を送信前の検査で守る必要がある。
この記事のポイント
- 開発側はAIへcommitやpushも任せられ、攻撃側にも公開情報の収集や解析にAIを使う事例がある。
- GitとAIへ渡せる情報を案件ごとに決め、ダミーやマスクを使い、方針をAGENTS.mdへ明記する。
- AIとGitのフック、GitHubのpush protectionを重ね、漏えいした認証情報は削除だけで済ませず無効化する。
AIで開発側と攻撃側はどう変わるか?
AIへ任せる範囲がコード生成からcommitやpushへ広がると、開発者が確認する対象も、コードの正しさに加えて外へ送る情報にまで広がる。 生成されたコードを人が読んで手動で保存する工程と、エージェントがファイルを変更して送信する工程では、人が中身を確認する機会が違うためだ。
Apiiroが2026年11月5日に公表した調査には、Claude Codeで秘密を含むコマンドを「Yes, and don't ask again」として恒久許可すると、コマンド文字列が.claude/settings.local.jsonの許可ルールへ平文で保存される実例がある。
そのローカル設定を誤ってcommitし、公開リポジトリへpushすると、保存された秘密も公開される。
同社は現行ファイルや履歴、共有設定などから計2,539件を検出したが、認証情報を使用した有効性の検証や接続先へのアクセスは行っていない。 この件数は形式と周辺情報から判定した検出総数であり、現在使える認証情報が2,539件あったという意味ではない。
攻撃側にも、AIを公開情報の収集や解析に利用する事例がある。 Anthropicの2026年9月の脅威報告は、同社が観測した攻撃活動で、公開コードやコンテナ等から認証情報を探し、見つかった情報を検証する工程を記録している。
公開されたコードを読んだり、関連する情報を組み合わせたりする作業にも、AIが使われる前提で備えたい。 AIが扱う開発情報を増やすなら、送る側の確認も、目視の注意と本人の記憶に依存する工程から見直すべきだと考える。
GitとAIへ渡してよい情報はどう決めるか?
情報を渡せる範囲は、企業や案件の契約と社内ポリシーから決める。 認証情報と個人情報を通常のコード保管場所へ入れないことを基本に、Gitへ保存できるものと、レビュー用AIへ送れるものをそれぞれ確認する。
テストにはダミーや合成データを使い、実際の問い合わせを説明に使う場合は、氏名だけでなく顧客名、契約内容、識別番号なども必要に応じてマスクする。 名前を消してもほかの情報から本人や案件を特定できることがあるため、再現に必要な条件だけを架空の入力へ置き換える方法を優先したい。
非公開のコードを承認されたクラウドAIへ渡せる案件もあれば、契約上、企業内で動かすローカルLLM(言語モデル)か人による確認が必要な案件もある。 例えば、Google Sheetsへ個人情報を保存するなら、その情報をGoogleへ預ける判断は既に行っている。 Geminiを禁止する場合にも、何を理由に異なる扱いとするのかを、情報管理の方針として説明できる必要がある。
同じGoogleのサービスでも、利用目的や保存期間、適用される契約や設定は異なり得るため、Sheetsへの保存を認めたことだけでGeminiへの送信も許可できるとは限らない。 サービス名やAIという分類だけで可否を決めず、実際の利用条件と情報の扱いを確認し、案件ごとに判断する。
ローカルLLMを選ぶ場合も入力とログ、バックアップの保存先を管理する。 クラウドとローカルの契約や学習利用、保存、外部モデルへの転送の違いは第2回で扱う予定とし、ここでは案件ごとに送れる情報を決めるところまでを押さえる。
決めた境界をAGENTS.mdへ書く
人が決めた方針は、Codexがプロジェクト指示として読むAGENTS.mdへ明記する。 例えば、次は説明用の方針であり、実際の案件では許可するデータと送信先を具体的に書き換えて使う。
この案件の情報の取り扱い
- Gitへ入れるのはコード、公開可能な文書、承認済みの合成データ。
- 実際の認証情報、個人情報、顧客から受領した原資料は入れない。
- テストはダミーを使う。実データの説明は必要な項目だけにし、マスクする。
- クラウドAIへ渡すのは、この案件で承認されたコードと合成データだけ。
- 社内限定情報は、許可された企業内LLMか人へ確認を依頼する。
- 判断できない情報は送信を保留し、担当者に確認する。
- commitとpushの前に指定の検査を実行し、失敗時に省略して進めない。
Claude Codeを併用するなら、CLAUDE.mdから同じ方針を参照できるようにし、エージェントによって異なる判断をしないようにする。 AGENTS.mdは判断の基準を共有する文書なので、読み取り権限や送信先の制限、実行前の検査は別に設定する。
決めた境界をどこで検査するか?
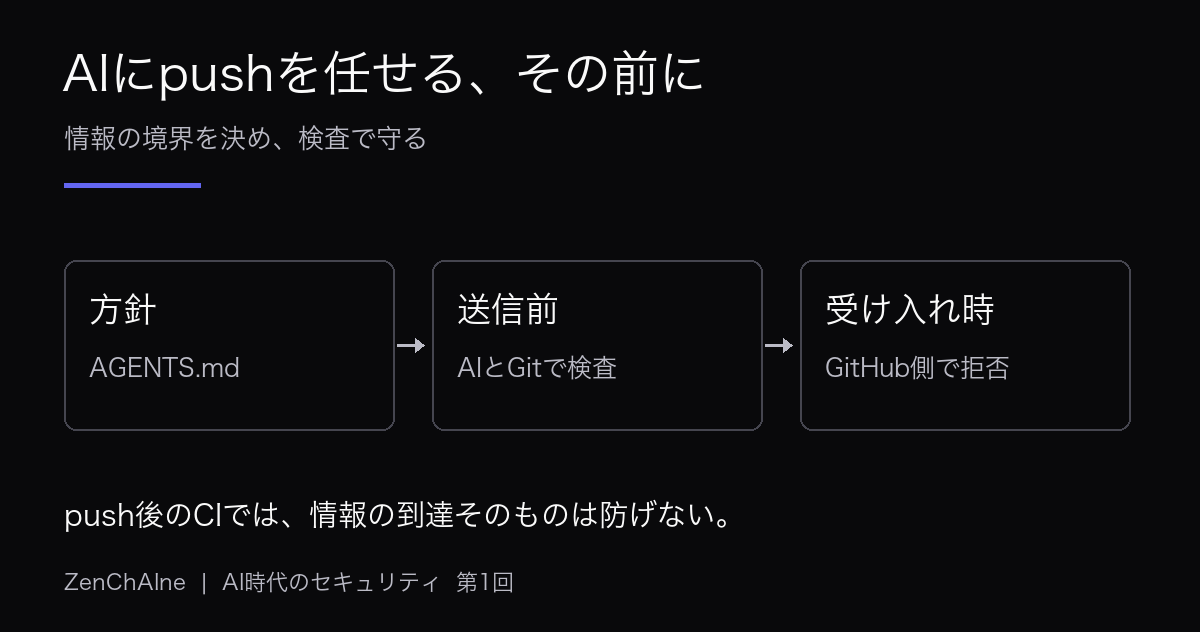
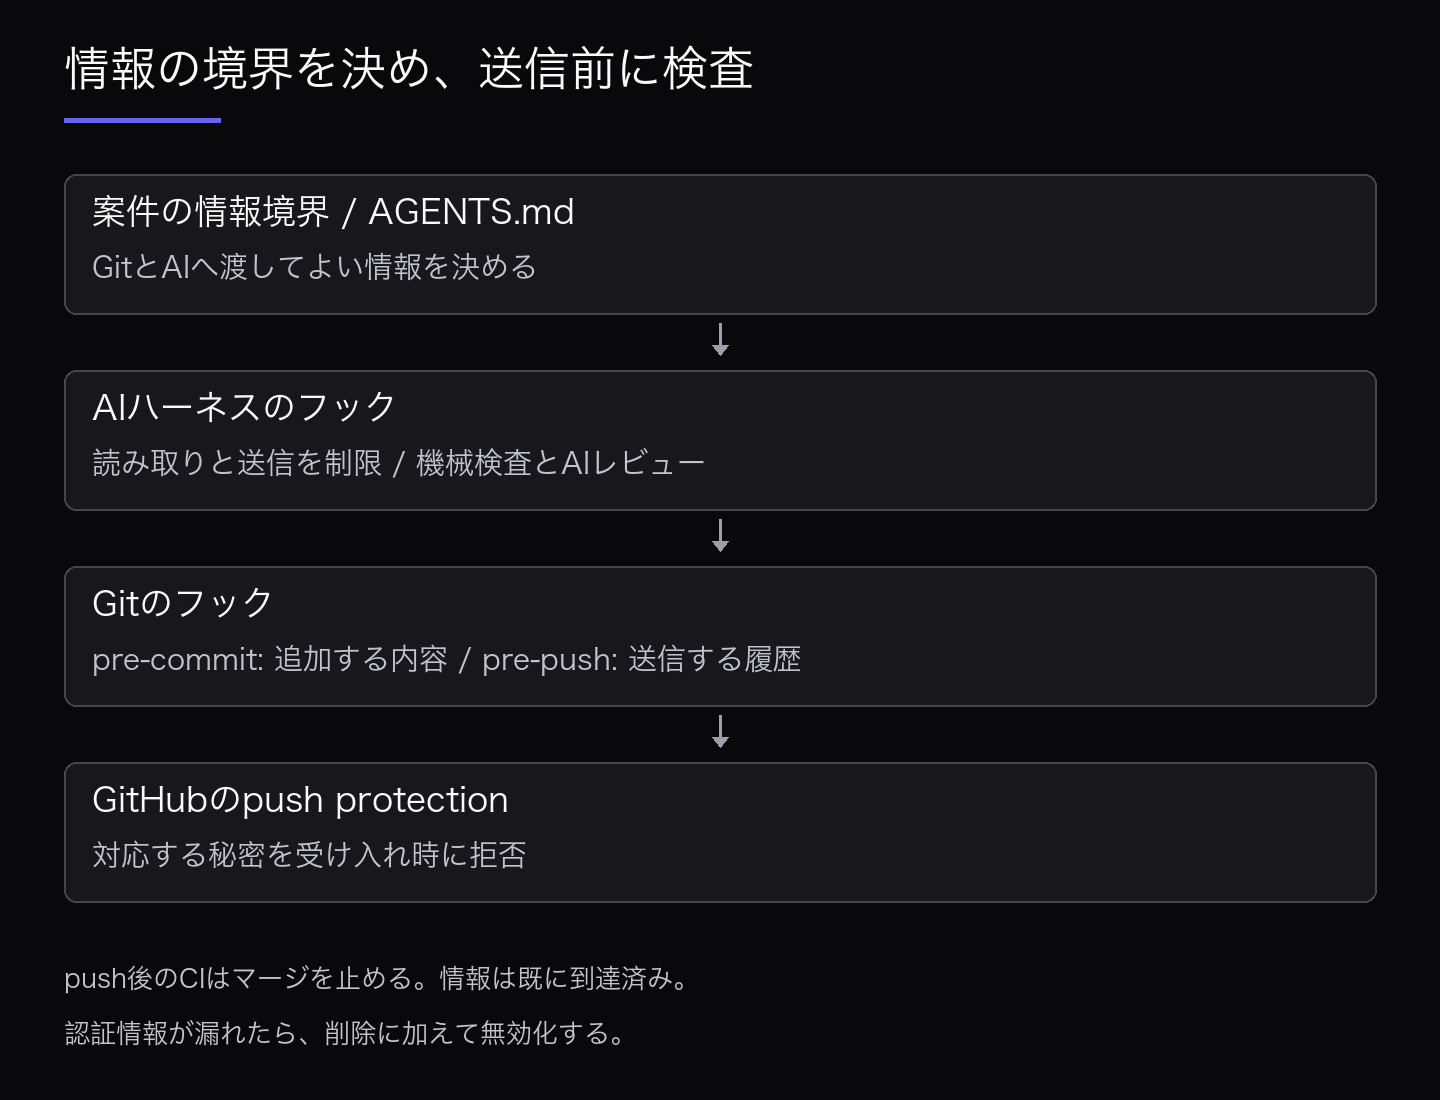
方針を実際に守るには、AIが操作するとき、Gitへ記録するとき、GitHubが受け入れるときに検査を重ねる。 既知の認証情報は機械で止め、顧客資料など意味を読まなければ判断しにくいものを、人やAIのレビューへ回す構成を勧める。
AIがツールを使う前に調べる
AIハーネスは、モデルにファイル操作やコマンド実行をさせ、権限や処理の進め方を管理する実行環境である。
CodexとClaude Codeには、対応するツールの実行前に検査するPreToolUseフックがあり、同期のコマンド検査から問題のある操作を拒否できる。
例えば、機密の保管場所を読む操作を制限し、送信前には対象の変更を機械検査する。
git pushという文字列だけを探す方法は別のスクリプトやAPI経由を取りこぼすため、送信権限と通信先も絞っておく。
シークレット(APIキーや秘密鍵などの認証情報)にはGitleaks等の検出を使い、顧客の実データや社内資料は、別のレビュー担当のサブエージェントへ規則と対象の変更を渡して確認させる。 レビュー担当を読み取り専用にして、機密の内容をログへ再掲させず、判断不能や時間切れでは送信を保留する制御を呼び出し元へ置く。
AIレビュー後に内容が変われば再検査し、例外の承認は担当者が行う。 Claude Codeのエージェント型フックは実験的なので、拒否の制御にはコマンド型を使い、AIの内容判断を補助として組み合わせる。
Gitへ記録し、送る前に調べる
Gitのフックも入れておけば、AIを使わずにターミナルやGUIで操作する場合も検査できる。
pre-commitでは次のコミットへ入れる内容を、pre-pushでは送信する各コミットを調べる。
最終状態の差分だけでは、途中のコミットに追加して後で削除したキーを取りこぼす。 禁止パスの検査と秘密検出を組み合わせ、AIが更新する設定ファイルも調べる。
Claude Codeでは、チームで共有する.claude/settings.jsonと個人用の.claude/settings.local.jsonを区別する。
ローカル設定はプロジェクトのignoreへ登録し、共有設定も、許可ルールなどに秘密が含まれていないか検査する。
公式資料にはローカル設定の作成時にグローバルignoreへ除外を追加する仕組みがあるが、端末ごとの設定だけに依存しない。
追跡済みのファイルはignoreの追加だけでは追跡から外れない。 認証情報の無効化を進めたうえで追跡を解除し、履歴や複製に残った内容も確認する。
GitHubの受け入れ時にも止める
ローカルフックは設定変更や--no-verifyで回避できるため、GitHub側でもpush protectionを有効にして、対応する秘密のpushを拒否する。
利用できる範囲はプランやリポジトリの公開範囲によって異なるので、設定の有効化、検出対象、回避を認める人を導入時に確認する。
禁止する保存先も決まっていれば、push rulesetでパス等を制限できる。 独自の受け入れ検査を実行するpre-receiveフックはGitHub Enterprise Serverの機能であり、GitHub.comでは利用中の機能に合わせて組み合わせる。
push後のGitHub Actionsは、その後のマージやデプロイを止めるために使う。 検査開始時には情報がGitHubへ届いているため、流出そのものを止める検査は送信前と受け入れ時に置く。
漏えいに気付いたときの対応
認証情報が外へ出た可能性があれば、無効化と再発行を先に進める。 ファイルやGitの履歴を削除しても、複製されたキーを使えなくすることはできないためだ。
個人情報や顧客資料については、送信先と公開期間、影響範囲を調べ、会社の事故対応手順に沿って報告と顧客対応の担当へつなぐ。 履歴の削除や関連する複製の対処は、ほかの開発者の作業も確認しながら進める。
よくある質問
Q. AGENTS.mdに書けば、AIの送信を止められるか?
AGENTS.mdへ方針を記すことで、AIが判断する基準を共有できる。 操作を止める検査と権限設定も追加し、文書の読み落としや判断の誤りを補う。
Q. AIレビューへ顧客情報を全部渡してよいか?
レビュー先も、案件の契約と情報の取り扱い方針に従って選ぶ。 ダミーやマスクで再現できるなら情報を減らし、社外へ渡せない場合は許可された企業内LLMか人へ回す。
Q. 検査が通れば、すべての機密を防げるか?
パスや認証情報の検査に加え、顧客資料や実データの混入を確認する。 新しい情報の種類や送信経路を追加するときは、方針と検査も更新する。
まとめ
AIへcommitやpushを任せる前に、GitとAIへ渡せる情報を案件ごとに決め、AGENTS.mdに記す。 その方針を権限設定と送信前の検査へ反映し、問題を見つけたときに止められる工程まで用意することを勧める。
エージェントへ渡す指示の管理はAgent Skillsの記事でも説明している。 偽の開発ツールや改ざんプラグインへの備えは連載第3回で扱う予定だ。 ZenChAIneでは、情報の取り扱いとAI開発フローの見直しについて、開発と技術支援の相談を受け付けている。
参考ソース
公式資料の確認日:2026年11月9日。製品の設定は導入時にも確認する。